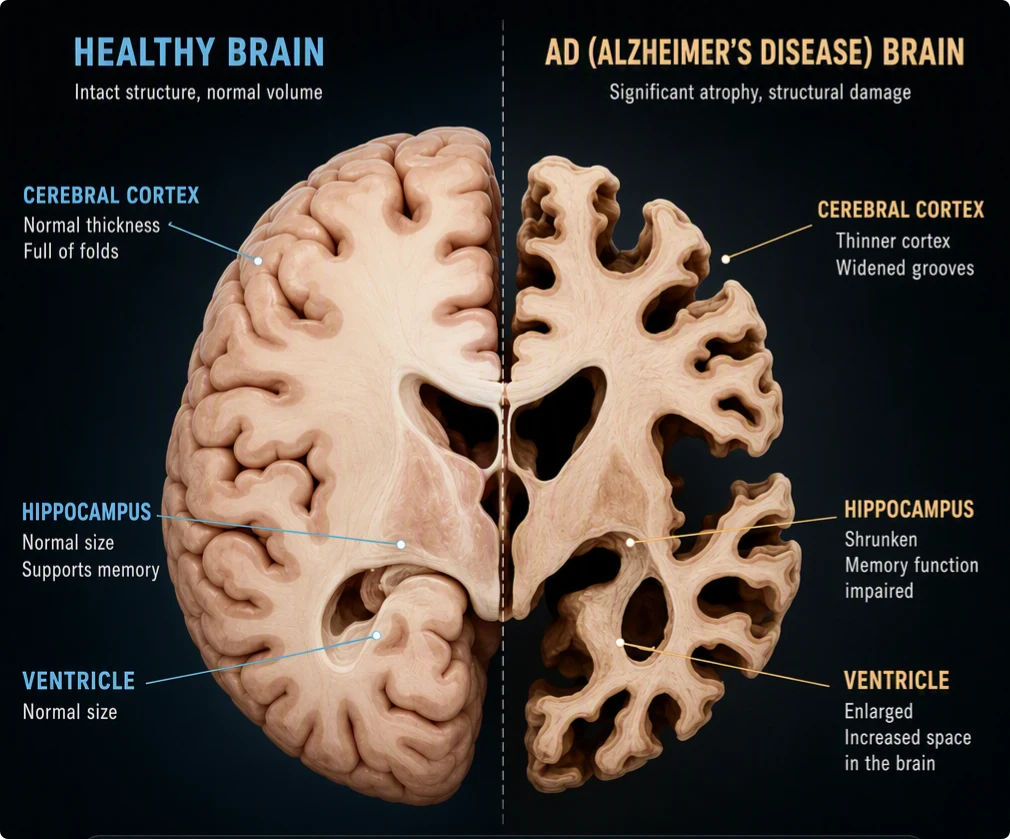
 层级 / 01 已解析
个体
疾病表型
解析疾病与健康状态之间具有区分度的解剖特征和功能特征。
MindCell 将虚拟细胞建模、疾病表型智能与专业生物医学 AI 汇聚于同一个由智能体协作驱动的研究环境。
跨个体、细胞和分子层面构建可计算的疾病模型,再利用同一生物模型筛选干预方案并发现治疗靶点。
层级 / 01 已解析解析疾病与健康状态之间具有区分度的解剖特征和功能特征。
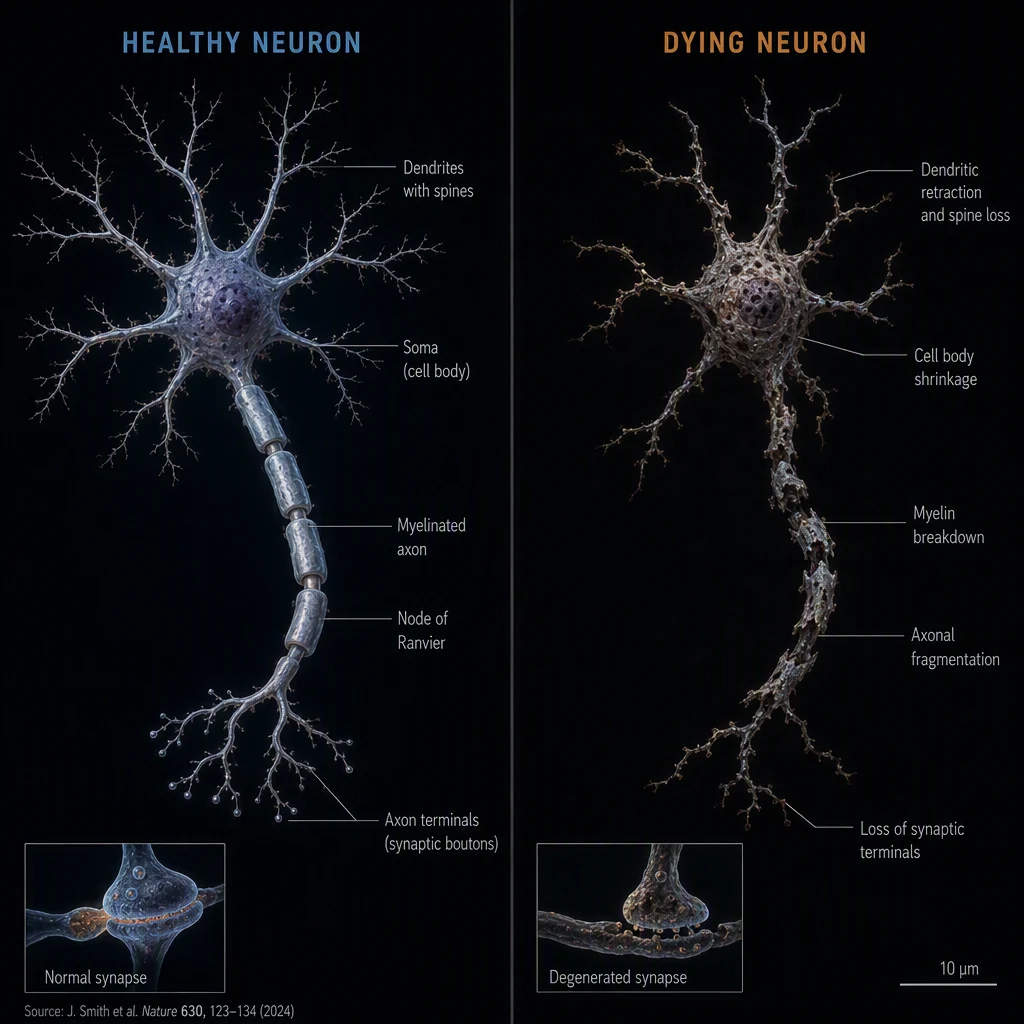 层级 / 02 已解析
将组织层面的变化追溯至其背后的细胞状态、形态与功能。
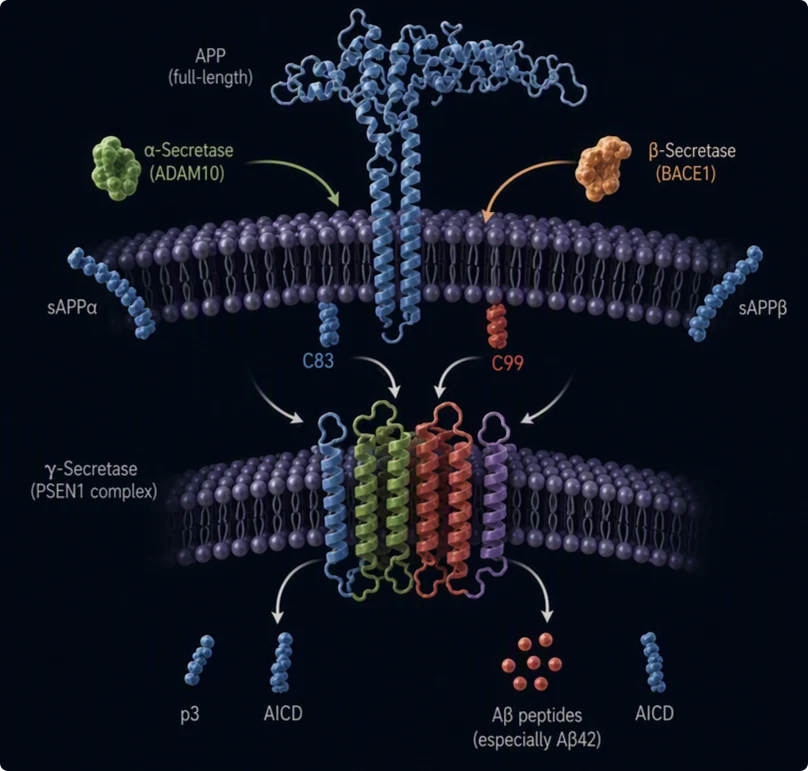 层级 / 03 已解析
将细胞功能异常关联到可干预的通路、蛋白质和分子事件。
基于多模态表型和患者证据,构建可计算的疾病模型。
开展计算机模拟扰动,并根据表型恢复效果而非单一代理指标筛选化合物。
发现与作用机制、预测响应和支持证据相关联的潜在干预靶点。
从表型到靶点,全程可追溯。
通过统一研究界面运行经过验证的生物学 AI 模型。MindCell 会将问题交给合适的专业模型,统一管理输入与输出,并让每项结果都可追溯。

复合物结构

结构与亲和力

单序列折叠

蛋白质动力学

开放结构平台

分子对接

神经网络对接

生成式设计

序列设计

蛋白质生成

结构感知蛋白模型

蛋白质语言模型

基因组语言模型

RNA 语言模型

RNA 结构与设计

分子基础模型
MindCell 科研博客
Aggrescan3D 1.0.2 静态分析为官方 RCSB Protein Data Bank 结构 2GB1 的 chain A 全部 56 个残基生成有限分数。最低值为 −3.5629,最高值为 1.1983,算术平均值为 −1.4135875。最高残基是 valine A:21,得分 1.1983;第二名是 methionine A:1,得分 0.5750。经过验证的交付物包括完整逐残基表、以分数注释的结构和原生 PNG/SVG profile。这个结果只是在所选结构模型下把位置排序,不能证明 2GB1 在实验中发生聚集,不能预测速率,也不能直接推荐 mutation。本次只在 Lin
阅读文章 →02PyMOL 3.1.0 把官方 RCSB/PDBe 的 1D3Z ubiquitin NMR 结构作为 mobile,对齐到官方 RCSB 1UBQ X-ray ubiquitin target。cmd.align 精确返回 [0.39735108613967896, 449, 5, 1.2869186401367188, 602, 381.0, 76]:五次 refinement 后,449 对 atom 的 RMSD 为 0.397351 Å;outlier rejection 前,602 对 atom 的 RMSD 为 1.286919 Å;raw alignment score 是 3
阅读文章 →03直接结论。 验证流程根据输入比对选择 IQ-TREE 模型,以 AVR-Mgk5GE162 作为外群完成定根,重建了13条祖先记录,并生成全部6项最终交付物。排序状态概率表包含68,807字节的显式概率记录,中间 IQ-TREE 文件没有被误报为最终结果。该结果在保留的第1次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →04直接结论。 ANARCI 识别出一条覆盖残基0–106的人源 κ 轻链,保留的 HMM 得分为197.0,e值为1.6 × 10⁻61,分配的胚系基因为 IGKV1-1201 与 IGKJ101。Kabat 编号 CSV 和 HMM 证据表均通过语义验证。该结果在保留的第1次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →05直接结论。 模型预测乙醇、苯和辛醇的 logS 分别为−0.0424460527、−1.9325820263和−2.3143366025,正确恢复“乙醇 苯 辛醇”的溶解度顺序,并保留分子量、LogP、可旋转键、芳香比例、SMILES 与单位。该结果在保留的第1次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →06直接结论。 GRNBoost2 返回8条排序后的转录因子—靶基因边,并恢复了 TF1→targetTF1 与 TF2→targetTF2 两条预设关系。摘要保留表达矩阵维度、调控因子列表、随机种子777、最高边、恢复标志,并明确说明重要性表示预测关联而不是因果证明。该结果在保留的第1次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →07直接结论。 流程创建了合成 T1w 图像、四时间点静息态 BOLD 图像、事件表、侧车文件、参与者元数据和数据集元数据。PyBIDS 成功查询受试者、任务、BOLD 文件、继承的重复时间和 NIfTI 形状;清单包含12行,真实 BIDS 验证器返回0个验证错误。该结果在保留的第1次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →08经过验证的 Datamol 工作流标准化六条带名称的 SMILES,计算精确分子量、cLogP、氢键供体数、氢键受体数和拓扑极性表面积,生成半径 2、长度 2048 bit 的 ECFP 指纹,计算对称 6 × 6 距离矩阵,把所有分子分配到五个 Butina cluster,并为 ibuprofen 生成五个三维 conformer。Datamol 0.12.5 在保留的第 4 次尝试中生成规范文本、CSV、JSON 与 SDF。验证器检查描述符有限、cluster 成员完整、距离矩阵对角线为零且对称,以及 SDF 能被读取并包含非零三维坐标。这些结果只是小型合成教学数据的计算表示,不证明生
阅读文章 →09直接结论。 DockQ 2.1.3 选择 AB:AB 模型—天然链映射,并返回 DockQ 1.000、iRMSD 0.000 Å、LRMSD 0.000 Å、fnat 1.000、F1 1.000和0个碰撞。由于合成模型坐标与天然夹具完全相同,这些精确值符合预期。该结果在保留的第1次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →10电子结构计算把分子几何、电荷、自旋多重度、理论方法和基组转化为有关电子与能量的定量结果。本文使用 Psi4 1.11,对中性单重态水分子执行限制性 Hartree–Fock 与 STO-3G 基组的单点计算。通过验证的运行得到总电子能 −74.9630783753 hartree、HOMO 能量 −0.3912317659 hartree、LUMO 能量 0.6053476877 hartree、前线轨道能隙 0.9965794536 hartree,以及程序分子坐标系中的偶极向量 (0, 0, 0.6787236267) debye。
阅读文章 →11分子静电势通常简称 ESP,它描述分子周围某个位置与单位正试探电荷之间的相互作用能。静电势同时包含原子核的正贡献和电子密度的负贡献,因此可以把空间中的电荷分布转化为可计算的场。研究者常用它讨论分子识别、氢键、取代基效应,以及哪些区域更容易与带正电或带负电的相互作用伙伴接近。
阅读文章 →12两条只有一个氨基酸差异的蛋白质序列,可以通过多种含义不同的方法进行比较。全局比对关心两条完整序列从起点到终点如何对应,局部比对寻找得分最高的局部片段,格式转换则应当在改变文件表示方式的同时保持生物序列不变。本次经过完整验证的工作流使用 EMBOSS 6.6.0 同时测试这三类操作:seqret 把一条含有 58 个残基的 FASTA 记录转换为 Swiss-Prot 文本,Needle 生成端到端全局比对,Water 生成局部比对。两个原生报告都给出 57/58,即 98.3% 一致性,以及 58/58,即 100.0% 相似性。
阅读文章 →13R 基团枚举通过把一个共享分子骨架与一组预先定义的取代基组合,生成可供筛选和分析的虚拟化合物库。本次经过完整验证的示例使用一个包含虚拟连接原子的苯基骨架,分别连接甲基、氨基和羟基。RDKit 2026.03.4 最终生成恰好三个经过清理且互不重复的分子:甲苯(Cc1ccccc1,C7H8)、苯胺(Nc1ccccc1,C6H7N)和苯酚(Oc1ccccc1,C6H6O)。对应平均分子量为 92.141、93.129 和 94.113 g/mol。
阅读文章 →14IgBLAST 能够把免疫球蛋白或 T 细胞受体序列与胚系 V、D、J 基因数据库进行比较,并给出重排基因分配、连接区、互补决定区和框架区等注释。在本文的小鼠免疫球蛋白重链实例中,IgBLAST 1.22.0 将 V、D、J 基因分别确定为 145A、DFL16.1 和 JH1,把该重排判定为可表达的 productive 序列,并返回完整连接区氨基酸序列 CASFITTVVATYWYFDVW。机器可读结果保存为完整 AIRR rearrangement TSV,面向读者的报告则经过逐字段复核,确保不会把完整 junction、CDR3 与 FWR3 混为一谈。
阅读文章 →15美国国家癌症研究所 Imaging Data Commons 提供可检索的公共放射学、病理学和衍生影像数据,并在元数据中记录许可证。可靠下载不应从盲目传输整个集合开始,而应先精确选择 series,检查 modality、instance count、预计体积和授权条件,再下载并重新打开每个 DICOM 对象。本文验证实例使用 idc-index 0.12.4 查询 IDC v24 中的一条 presentation-state series。索引返回一个大小为 0.001266 MB 的实例,许可证为 CC BY 3.0。下载文件随后由 pydicom 3.0.2 重新读取,Study、Se
阅读文章 →16科学原理导论 科学软件能否启动,只是判断工作流是否可信的起点,而不是终点。一个可以复核的研究流程必须保留输入材料,说明计算假设,记录软件版本与运行平台,生成可检查的结构化产物,并且把“程序输出了什么”与“这个输出可以支持什么结论”严格分开。controlled document-topic triage 的价值在于把宽泛问题收敛为输入、参数、运算和输出都清晰的有限任务;它给出的是决策过程中的一项证据,而不是脱离上下文即可成立的科学结论。
阅读文章 →17流程解析了3张质谱图,包括2个参考谱和1个查询谱。查询碎片整体偏移2 Da,因此精确贪婪余弦得分为0;修饰余弦考虑前体离子偏移后,以0.9999999999999999的得分和5个匹配峰识别出咖啡因参考谱,无关参考谱仍为0。。该结果在保留的第5次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →18GROMACS 2024.5 用27步完成最速下降能量最小化。势能从136.938477 kJ/mol降至−0.972452 kJ/mol,运行报告收敛;原生EDR、TRR与GRO产物均成功重新打开检查。。该结果在保留的第5次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →19OpenMM 8.3.1 明确选择CPU平台。最小化将势能从4.5 kJ/mol降至3.8518598887744717×10⁻³² kJ/mol;随后运行20个1飞秒Langevin-middle步,最终势能为5.680147519456703×10⁻⁵ kJ/mol,并保留两个以纳米计的三维坐标。。该结果在保留的第5次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →205条输入中有4个有效结构和1个显式无效SMILES错误。4个有效结构中,Rule of Five、Veber、PAINS、常见警报与NIBR检查均各有3个通过。Rhodanine未通过PAINS和NIBR;长链烷烃未通过Rule of Five、Veber和常见警报。。该结果在保留的第4次尝试中通过原生执行、真实聊天端到端执行和语义产物验证,只能在本演示的数据、方法和限制范围内解释。
阅读文章 →碳水晶硅
如需开展科研合作、学术协作或咨询 MindCell,请直接联系我们的团队。
research@cosinx.com